از سامانهمحوری تا دادهمحوری؛ سازمانهای ایرانی داده دارند، اما داده آماده ندارند
در بیستونهمین نمایشگاه الکامپ، معاون فناوری اطلاعات گروه فنآوا در گفتوگو با سیتنا از تغییر رویکرد این مجموعه خبر داد: عبور از مدلهای سنتی «سامانهمحور» به مدلهای «دادهمحور» و مبتنی بر هوش مصنوعی. این جمله کوتاه، دقیقترین توصیف از چیزی است که امسال در بازار فناوری سازمانی ایران در حال وقوع است.

گزارش آگهی/ در بیستونهمین نمایشگاه الکامپ، معاون فناوری اطلاعات گروه فنآوا در گفتوگو با سیتنا از تغییر رویکرد این مجموعه خبر داد: عبور از مدلهای سنتی «سامانهمحور» به مدلهای «دادهمحور» و مبتنی بر هوش مصنوعی. این جمله کوتاه، دقیقترین توصیف از چیزی است که امسال در بازار فناوری سازمانی ایران در حال وقوع است.
اما میان اعلام این رویکرد و اجرای آن، یک فاصله عملیاتی وجود دارد که کمتر دربارهاش حرف زده میشود. مدل دادهمحور، به داده نیاز دارد — و منظور از داده، فایل نیست. قاعدهای تجربی در میان تیمهای داده میگوید بخش عمده زمان هر پروژه تحلیلی، نه صرف مدلسازی، که صرف پیدا کردن، تمیز کردن و یکپارچه کردن داده میشود. سازمان ایرانی معمولاً در همین مرحله متوقف میشود، نه در مرحله انتخاب الگوریتم.
این گزارش به یک پرسش مشخص میپردازد: از میان دادههایی که یک سازمان ایرانی امروز واقعاً در اختیار دارد، کدامیک آمادهترین نقطه شروع برای حرکت به سمت تصمیمگیری دادهمحور است؟ پاسخ، برخلاف انتظار، در لایههای پرهیاهوی فناوری نیست؛ در جایی است که سالهاست بیسروصدا و روزانه داده تولید میکند و کسی سراغش نرفته است: داده حضور و غیاب کارکنان.
«داده داریم» یعنی چه؟
وقتی از مدیران ارشد فناوری پرسیده میشود سازمانشان چه دادهای دارد، پاسخ معمولاً فهرستی بلند است. اما اگر همان فهرست را با سه معیار عملی بسنجیم — پیوستگی ثبت، دانهبندی زمانی، و قابلیت اتکا برای حسابرسی — تصویر واقعیتر میشود:
| لایه داده | وضعیت رایج در سازمان ایرانی | دانهبندی | آمادگی برای تحلیل |
| مالی و حسابداری | ساختاریافته و ممیزیشده | ماهانه | بالا، ولی تجمیعشده و دیرهنگام |
| فروش و CRM | ناقص و وابسته به ورود دستی | رویدادی | متوسط |
| تولید و SCADA | حجیم و دقیق، ولی جزیرهای | ثانیهای | متوسط، نیازمند یکپارچهسازی سنگین |
| تردد و کارکرد کارکنان | خودکار، پیوسته، بدون ورود دستی | رویدادی و دقیق | بالا — و کمترین استفاده |
| اسناد و مکاتبات | متنی و غیرساختاریافته | پراکنده | پایین بدون پردازش زبانی |
سطر چهارم، نکته اصلی این گزارش است. داده تردد، تنها لایهای است که همزمان چهار ویژگی دارد: بهصورت خودکار و بدون دخالت انسانی ثبت میشود، پیوستگی روزانه دارد، دقت زمانی در حد دقیقه دارد، و مستقیماً به یک خروجی مالی (حقوق و دستمزد) متصل است. با این حال، در بیشتر سازمانها فقط برای یک کار استفاده میشود: بستن کارکرد آخر ماه.
چرا لایه منابع انسانی، عملیترین نقطه شروع است
سه دلیل فنی، نه بازاریابی:
یکم، داده حقیقت زمینی دارد. برخلاف دادههای خوداظهاری مثل گزارش پیشرفت پروژه یا ثبت فعالیت در CRM، رکورد تردد یک رویداد فیزیکی است که اتفاق افتاده یا نیفتاده. برای هر مدل تحلیلی، دادهای که سوگیری اظهاری ندارد ارزش بیشتری دارد.
دوم، حجم کافی و نه بیش از حد. سازمانی با پنج هزار کارمند، ماهانه در حدود چند صد هزار رکورد تردد خام تولید میکند — حجمی که برای یافتن الگو کافی است اما برخلاف داده SCADA، به زیرساخت پردازشی سنگین نیاز ندارد.
سوم، مسیر ارزش کوتاه است. خروجی تحلیل این لایه مستقیماً به تصمیمهای قابل اجرا میرسد: چند نفر در کدام واحد کم است، کدام الگوی شیفت بیشترین اضافهکاری را تولید میکند، کجا خستگی تجمعی در حال انباشت است. لازم نیست ابتدا یک پروژه یکپارچهسازی دوساله انجام شود.
برای روشنتر شدن موضوع، بد نیست به آنچه یک سامانه حضور و غیاب سازمانی عملاً ثبت میکند نگاه کنیم: زمان دقیق ورود و خروج به تفکیک دروازه و ناحیه، تطبیق هر تردد با الگوی شیفت، ساعات اضافهکاری همراه با سابقه تأیید، انواع مرخصی و مأموریت با گردش کارشان، و تاریخچه هر اصلاح دستی. این مجموعه، یک سری زمانی پیوسته از رفتار عملیاتی کل سازمان است — چیزی که هیچ سامانه دیگری در سازمان با این دانهبندی تولید نمیکند.
شرط لازم اما این است که داده در یک بستر واحد و با تاریخچه کامل نگهداری شده باشد. یک سیستم حضور و غیاب سازمانی، در این نگاه، صرفاً ابزار محاسبه حقوق نیست؛ لایه جمعآوری داده عملیاتی سازمان است — و کیفیت آن تعیین میکند هر تحلیل بعدی روی چه پایهای بنا میشود.
چهار مانعی که این داده را غیرقابل استفاده میکند
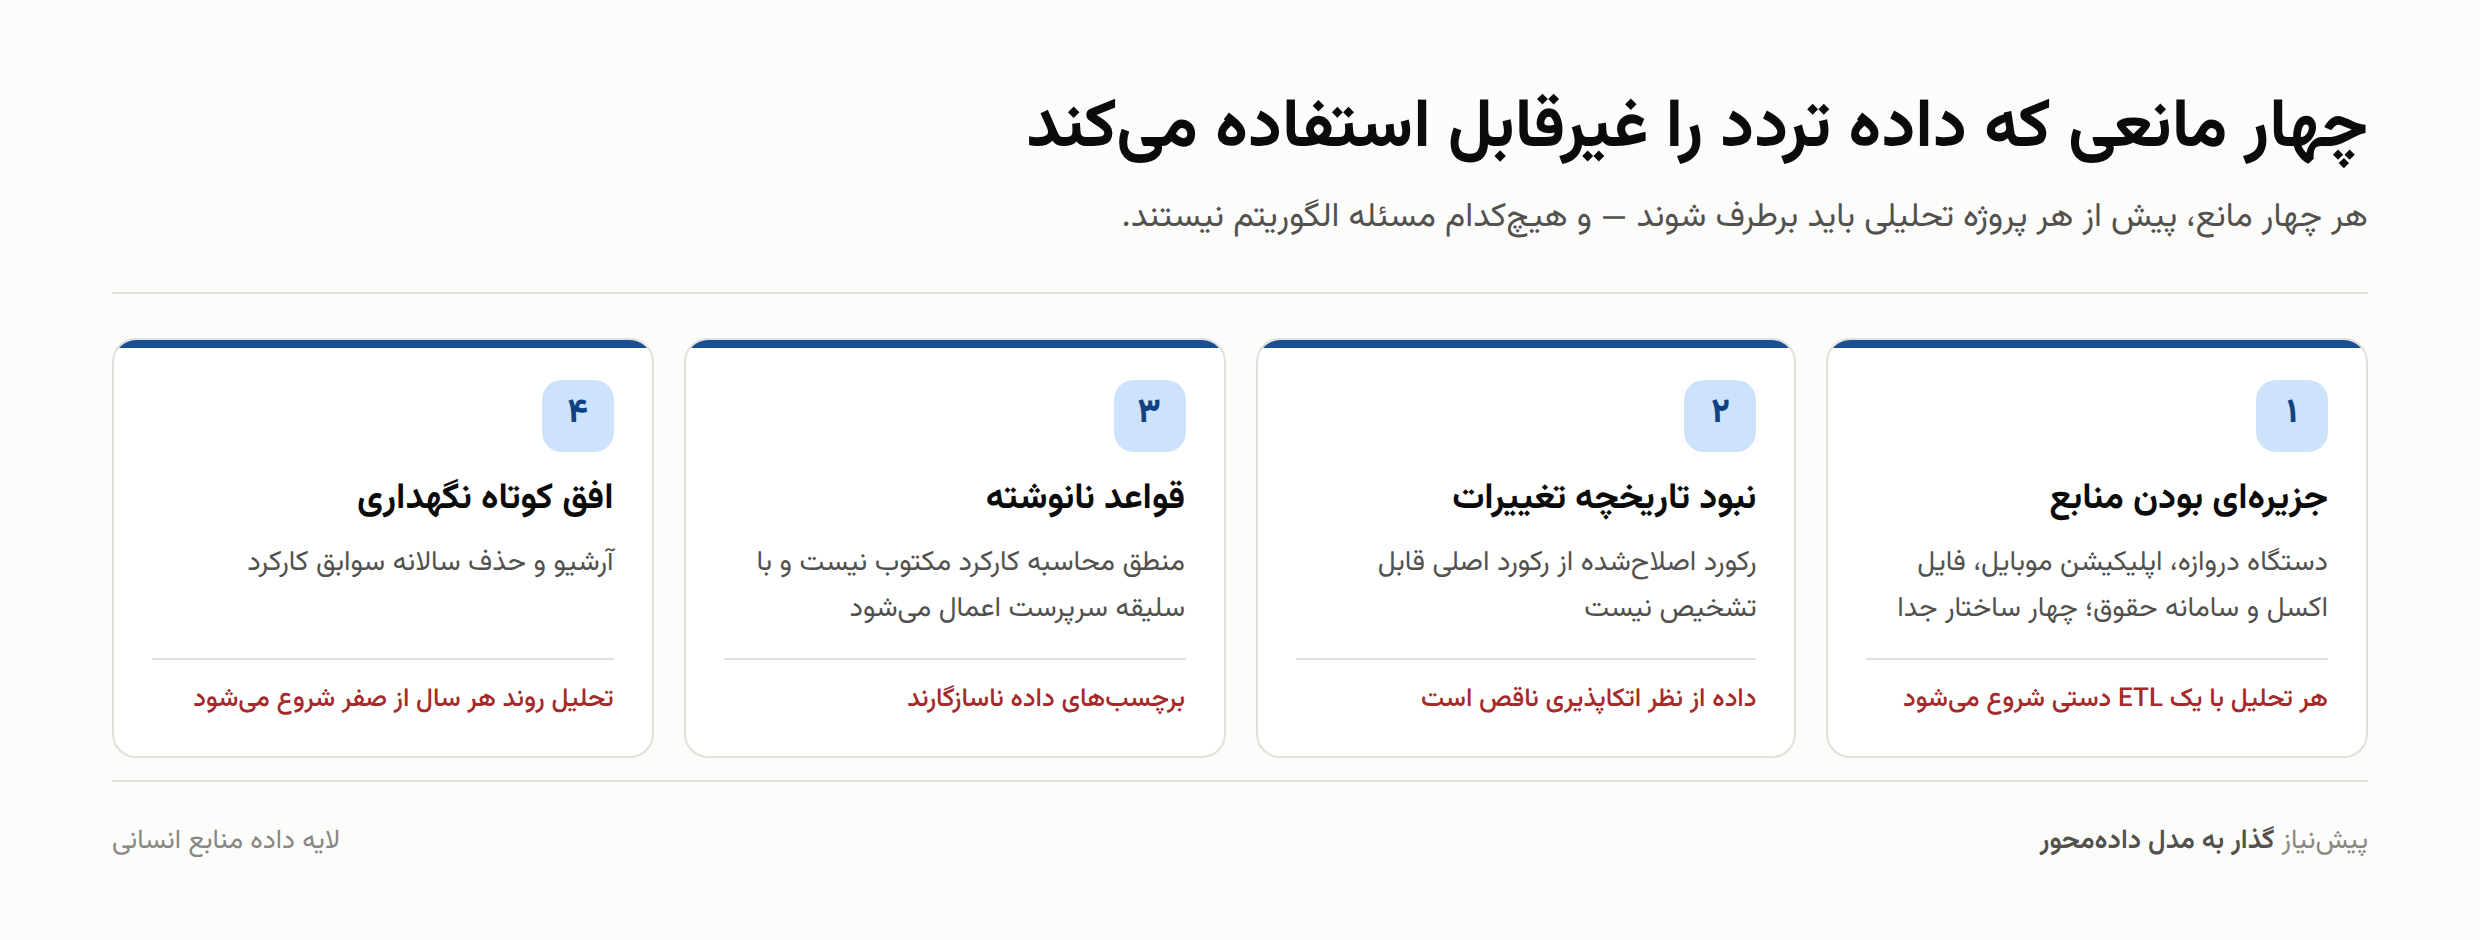
در عمل، بیشتر سازمانها این داده را دارند ولی نمیتوانند از آن استفاده کنند. چهار مانع تکرارشونده:
۱. جزیرهای بودن منابع. دستگاه کارتزنی دروازه، اپلیکیشن موبایل نیروی میدانی، فایل اکسل واحد اداری و سامانه حقوق، چهار منبع جدا با چهار ساختار متفاوتاند. تا وقتی این چهار در یک مدل داده واحد ننشینند، هر تحلیلی با یک پروژه ETL دستی شروع میشود. نمونه رایج این وضعیت در سازمانهای چندشعبهای دیده میشود: یک کارمند در سامانه حضور و غیاب شعبه با یک شناسه ثبت شده و در سامانه حقوق مرکزی با شناسهای دیگر.
۲. نبود تاریخچه تغییرات. رکوردی که سه ماه بعد اصلاح شده، از دید پایگاه داده با رکورد اصلی تفاوتی ندارد. برای تحلیل روند، تشخیص مغایرت و هر کاربرد حسابرسی، نبودِ ستون «چه کسی، کی، چرا تغییر داد» یعنی داده از نظر اتکاپذیری ناقص است.
۳. قواعد نانوشته. بخش بزرگی از منطق محاسبه کارکرد در سازمانهای ایرانی مکتوب نیست و با سلیقه سرپرست اعمال میشود. دادهای که منطق تولیدش مستند نیست، برای مدلسازی قابل اتکا نیست — چون خود برچسبها ناسازگارند.
۴. افق کوتاه نگهداری. تحلیل روند به داده چندساله نیاز دارد. سازمانی که سوابق را سالانه آرشیو و پاک میکند، عملاً هر سال از صفر شروع میکند.
سه کاربرد واقعبینانه — و سه کاربردی که هنوز زود است
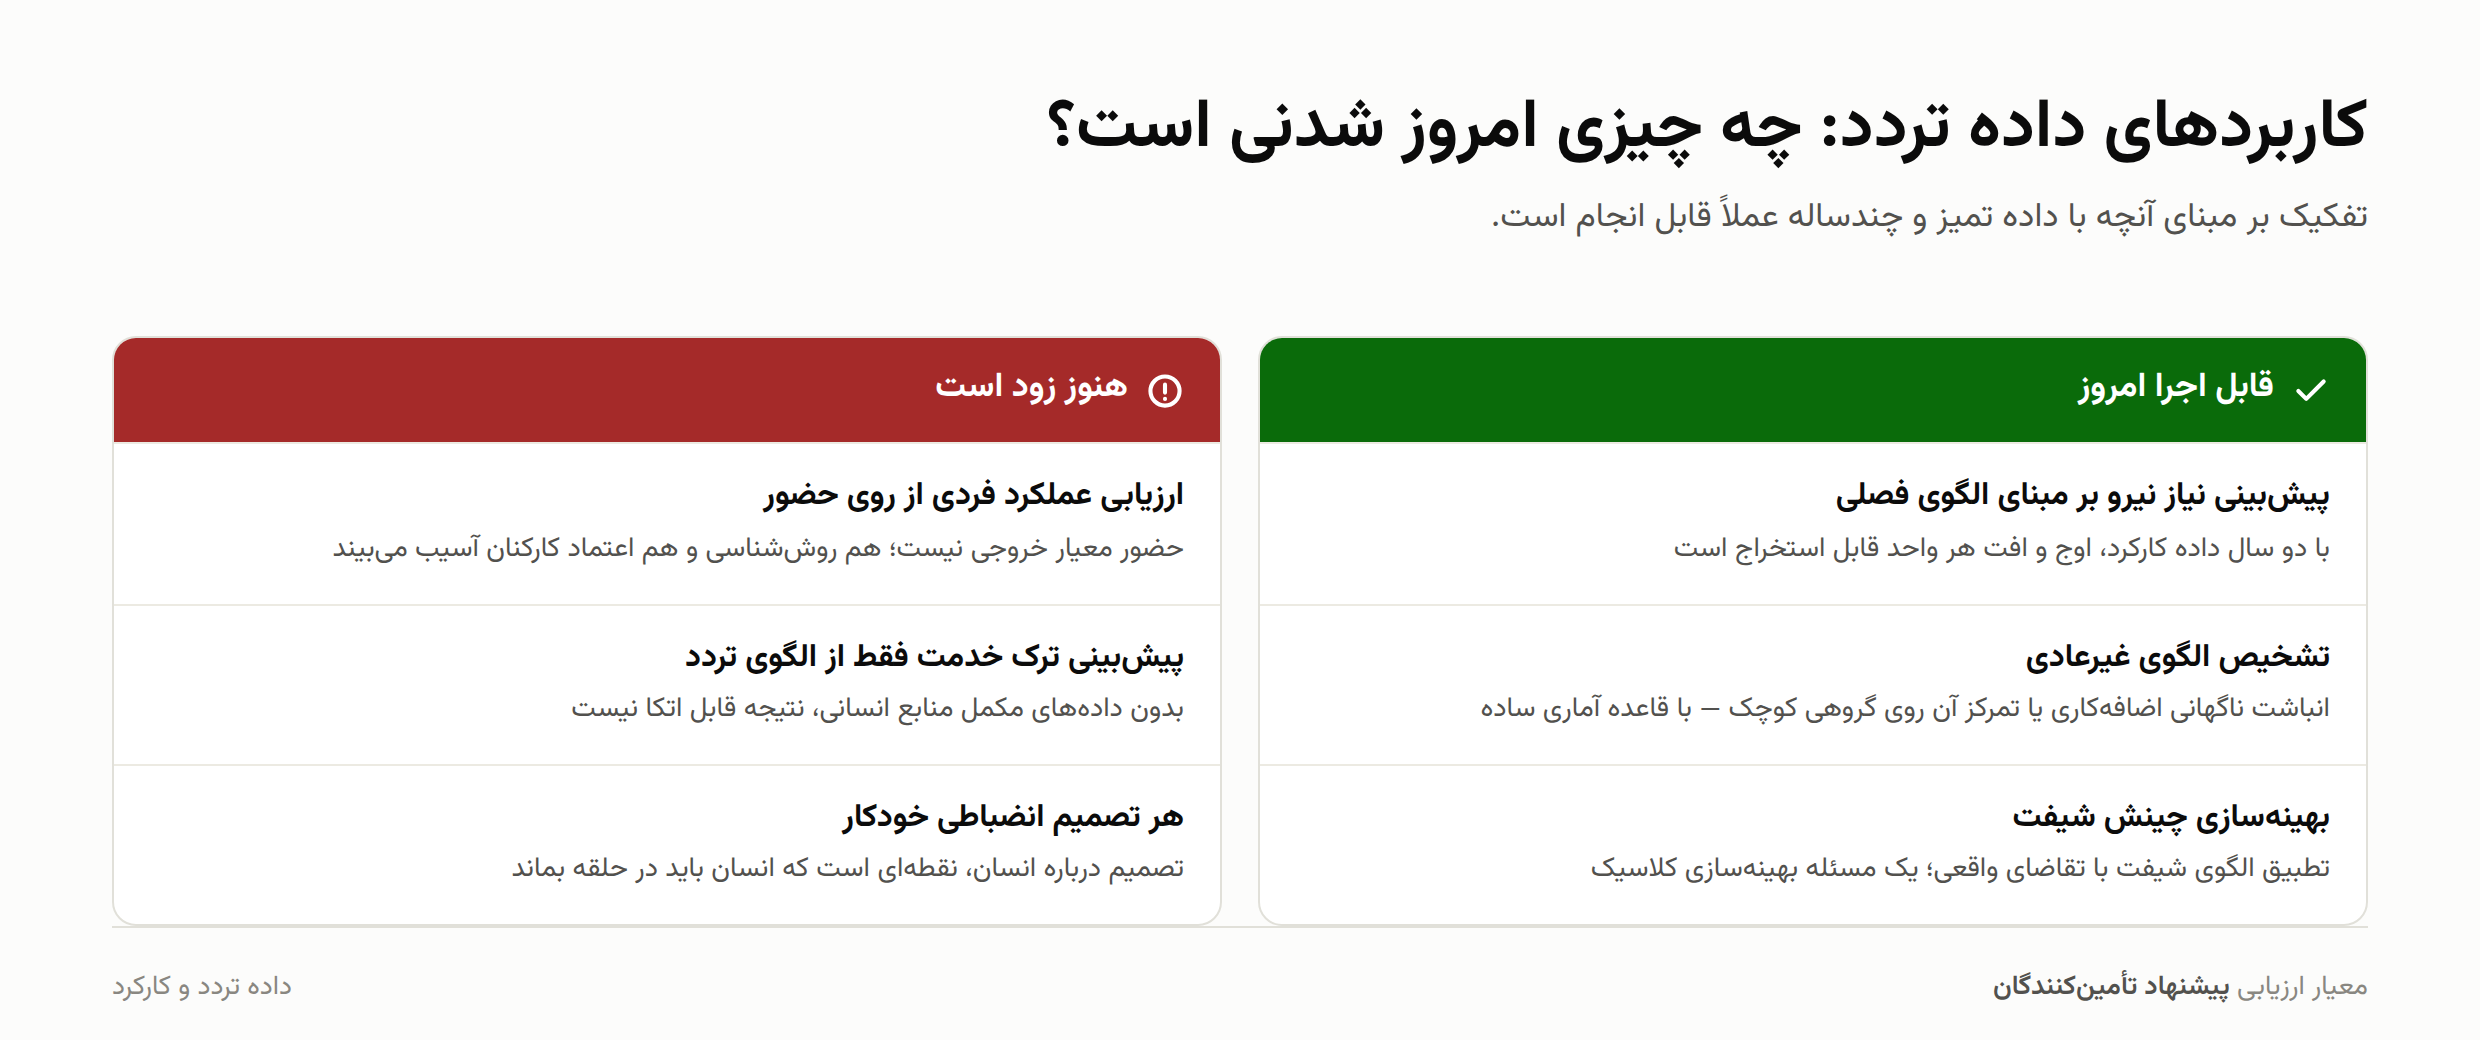
بازار فناوری ایران در معرفی کاربردهای هوش مصنوعی گاهی از واقعیت جلو میزند. تفکیک زیر، بر مبنای آنچه با داده تردد تمیز و چندساله عملاً قابل انجام است:
قابل اجرا امروز:
-
پیشبینی نیاز نیرو بر مبنای الگوی فصلی. با دو سال داده کارکرد، الگوی اوج و افت هر واحد قابل استخراج است و برنامهریزی جذب و اضافهکاری از حدس به محاسبه تبدیل میشود.
-
تشخیص الگوی غیرعادی. انباشت ناگهانی اضافهکاری در یک واحد، یا تمرکز ۸۰ درصد اضافهکاری روی ۲۰ درصد افراد، نشانههای ساختاریاند که با یک قاعده آماری ساده — نه مدل پیچیده — قابل شناساییاند.
-
بهینهسازی چینش شیفت. تطبیق الگوی شیفت با تقاضای واقعی، یک مسئله بهینهسازی کلاسیک است و به داده تاریخی نیاز دارد، نه به مدل زبانی.
هنوز زود است:
-
ارزیابی عملکرد فردی بر مبنای داده حضور. حضور، معیار خروجی نیست و استفاده از آن در ارزیابی، هم از نظر روششناسی و هم از نظر اعتماد کارکنان پرریسک است.
-
پیشبینی ترک خدمت صرفاً از روی الگوی تردد، بدون دادههای مکمل منابع انسانی.
-
هر کاربردی که خروجیاش تصمیم انضباطی خودکار باشد. تصمیم درباره انسان، نقطهای است که باید انسان در حلقه بماند.
تفکیک این دو فهرست، خودش یک معیار سنجش برای ارزیابی پیشنهادهای فروشندگان است. تأمینکنندهای که کاربردهای ستون دوم را بهعنوان قابلیت آماده معرفی میکند، یا دادهای در اختیار دارد که سازمان شما ندارد، یا دارد درباره بلوغ راهکارش اغراق میکند.
نقشه چهار گامی
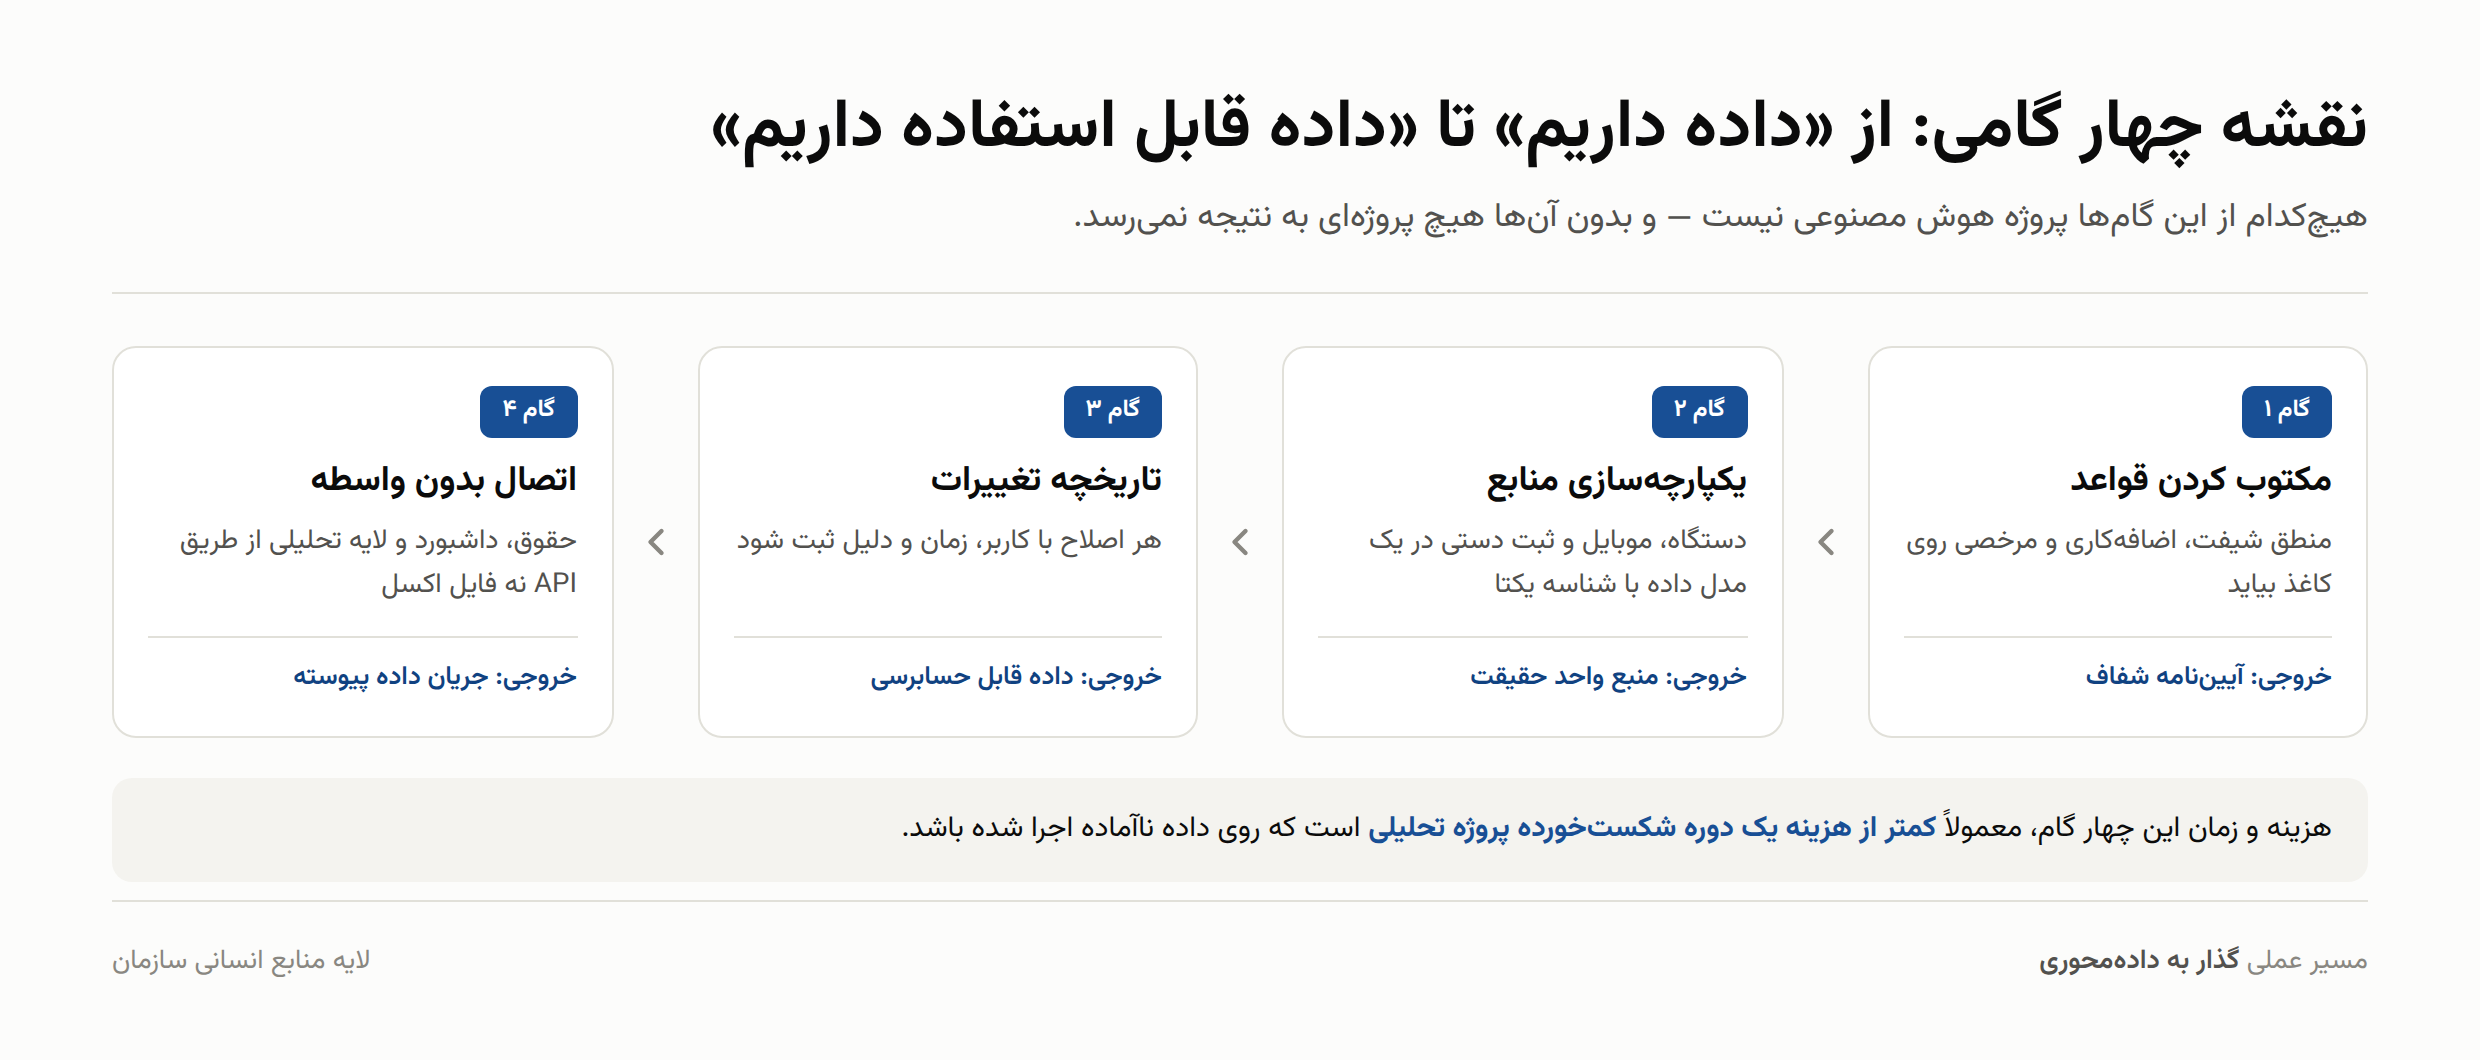
برای سازمانی که میخواهد از وضعیت «داده داریم» به «داده قابل استفاده داریم» برسد:
گام یک — مکتوب کردن قواعد. پیش از هر پروژه فنی، منطق محاسبه شیفت، اضافهکاری و مرخصی باید روی کاغذ بیاید. این مرحله معمولاً چند قاعده متناقض را آشکار میکند که تا امروز نانوشته اجرا میشدهاند.
گام دو — یکپارچهسازی منابع. همه منابع ثبت تردد — دستگاه، موبایل، ثبت دستی — باید در یک مدل داده واحد بنشینند، با شناسه یکتای پرسنلی مشترک.
گام سه — فعال کردن تاریخچه تغییرات. هر اصلاح باید کاربر، زمان و دلیل داشته باشد. این گام هزینه فنی کمی دارد و بیشترین اثر را بر اتکاپذیری داده میگذارد.
گام چهار — اتصال بدون واسطه به مصرفکنندههای داده. حقوق و دستمزد، داشبورد مدیریتی و در ادامه لایه تحلیلی، باید از طریق وبسرویس یا API به همین منبع وصل شوند، نه از طریق فایل اکسل.
نکته مشترک هر چهار گام: هیچکدام پروژه هوش مصنوعی نیستند. اما بدون آنها، هیچ پروژه هوش مصنوعی سازمانی به نتیجه نمیرسد. تجربه پروژههای سازمانی نشان میدهد هزینه و زمان این چهار گام، معمولاً کمتر از هزینه یک دوره شکستخورده پروژه تحلیلی است که روی داده ناآماده اجرا شده باشد.
جمعبندی
گذار از سامانهمحوری به دادهمحوری، بیش از آنکه مسئله انتخاب فناوری باشد، مسئله آمادهسازی زیرساخت داده است. سازمانهایی که این گذار را با بلندپروازانهترین لایه شروع میکنند، معمولاً در مرحله تمیزسازی داده متوقف میشوند؛ آنهایی که از عملیاتیترین و ساختاریافتهترین لایه موجودشان شروع میکنند، زودتر به خروجی قابل دفاع میرسند.
در بیشتر سازمانهای ایرانی، آن لایه همان داده حضور و غیاب است: دادهای که هر روز بهصورت خودکار تولید میشود، سالهاست انباشته شده، و تاکنون فقط برای بستن کارکرد آخر ماه استفاده شده است.
انتهای پیام


افزودن دیدگاه جدید